2026年7月1日
當 PCIe 7.0 進入量產規劃、224G SerDes 成為次世代 AI 伺服器交換器的標配, R&D 工程師面對的不只是更高層數或更複雜疊構,而是一個物理底線問題:在 PCIe 5.0 時代,M7 等級 CCL 還能讓訊號跑 12 到 14 英吋;到了 PCIe 6.0/7.0,板材選錯,訊號可能跑不到 5 英吋就已經衰減到接收端無法判讀。M7、M8、M9、M10 不再是 CCL 廠的行銷分級,而是設計階段就必須拍板的硬約束。本文從訊號物理出發,拆解四個等級的差異、選材決策矩陣,以及 2026 年低介電 CCL 的供應鏈現況。
訊號在銅線中傳播時,頻率越高、衰減越嚴重,這已不是新概念,但 2026 年的關鍵變化是「衰減速度」呈現非線性跳升:
這代表設計時的層間互連距離、midplane 走線長度、connector launch 設計,全被 CCL 等級反向綁定。一旦主機板採用 224G PAM4,CCL 等級就幾乎沒有「降規省成本」的空間——訊號根本到不了 GPU 或 switch 晶片。
倒過來看:你計畫使用的 CCL 等級,定義了訊號鏈路最遠能拉多遠,也決定了整機架的物理佈局。
很多人以為從 M8 升到 M10 是「換個樹脂配方」,事實上是樹脂、玻纖布、銅箔三大材料的同步換代——任何一項不到位,整板高頻表現就無法達標。
三者必須同步達標,這也是 M9/M10 在量產良率上自然低於 M7/M8 的根本原因——升級的不是配方,是整套材料生態。
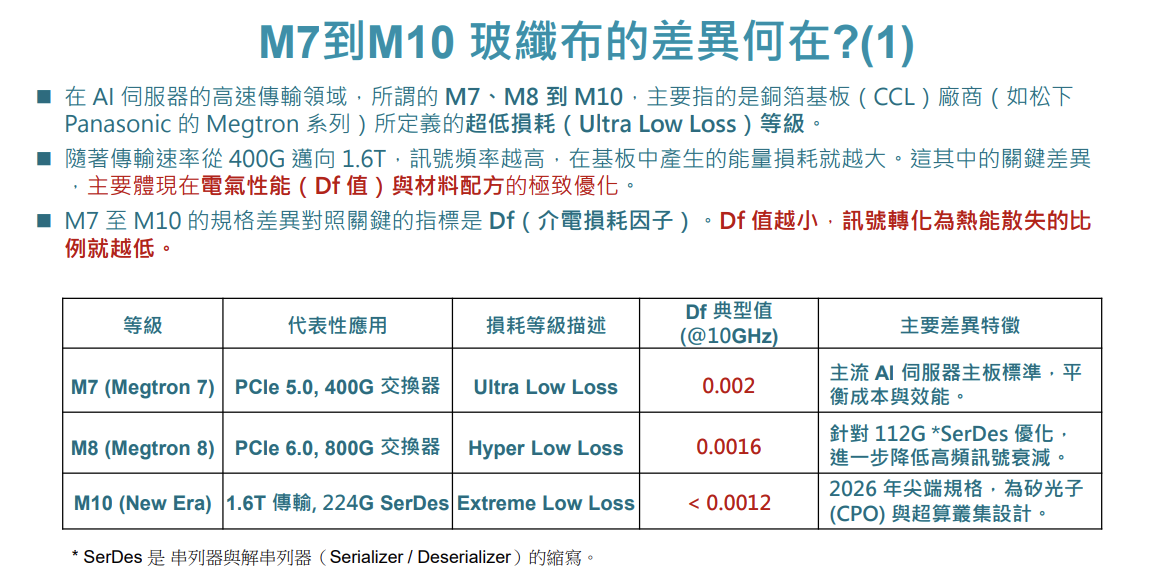
對 R&D 工程師而言,選材的第一步是先把「設計目標訊號速率」對齊到 CCL 等級。下表整理了 M6 到 M10 的對應關係:
| CCL 等級 | 業界稱呼 | Df @10GHz | 對應傳輸速率 | 主力應用 | | :--- | :--- | :--- | :--- | :--- | | M6 | Very Low Loss | 0.003–0.005 | PCIe Gen 4 / 25G–56G | 通用伺服器、100G/400G 交換器 | | M7 | Ultra Low Loss | 0.002–0.003 | PCIe Gen 5 / 56G–112G | 早期 AI 伺服器(A100/H100)、400G 交換器 | | M8 | Extreme Low Loss | 0.0015–0.002 | PCIe Gen 6 / 112G PAM4 | 當前 AI 主流(NVIDIA Blackwell/GB200)、800G 交換器 | | M9 | Super Extreme Low Loss | 0.0010–0.0015 | PCIe Gen 7 / 224G PAM4 | 次世代 AI(NVIDIA Rubin)、1.6T 交換器、光通訊模組 | | M10 | Hyper Extreme / PTFE 等級 | <0.0010 | 後 PCIe Gen 7 / 224G+ | 3.2T 交換器、矽光子(CPO)封裝載板、高頻雷達 |
實務上的選材邏輯:先決定訊號速率,再倒推 CCL 等級;再從 CCL 等級綁定的玻纖布與銅箔規格,反算良率風險與料源週期。如果 BOM 出來才發現 M9 等級交期不確定,往往等於整個專案重排程。
M8 以上等級的 CCL 並不是技術專利問題,而是上游材料同時卡關:
結果是:規格跳升速度若超過材料廠商一年內能跟上的節奏,整條 BOM 就會卡住。AWS、Google、NVIDIA 的 AI 伺服器規格從 M7 跳到 M10 通常只給材料廠商不到 18 個月的調適時間,這是 2026 年供應斷層的根本原因。
對 R&D 而言,意味著高階 CCL 的選材決策必須提早 6 到 9 個月與板廠對齊料源狀況,不能等到 layout 接近完成才回頭找料。
過去市場習慣把 CCL 高階產能視為日系廠的禁地,但 2025 下半年到 2026 的東南亞擴張,正在改寫這個結構:
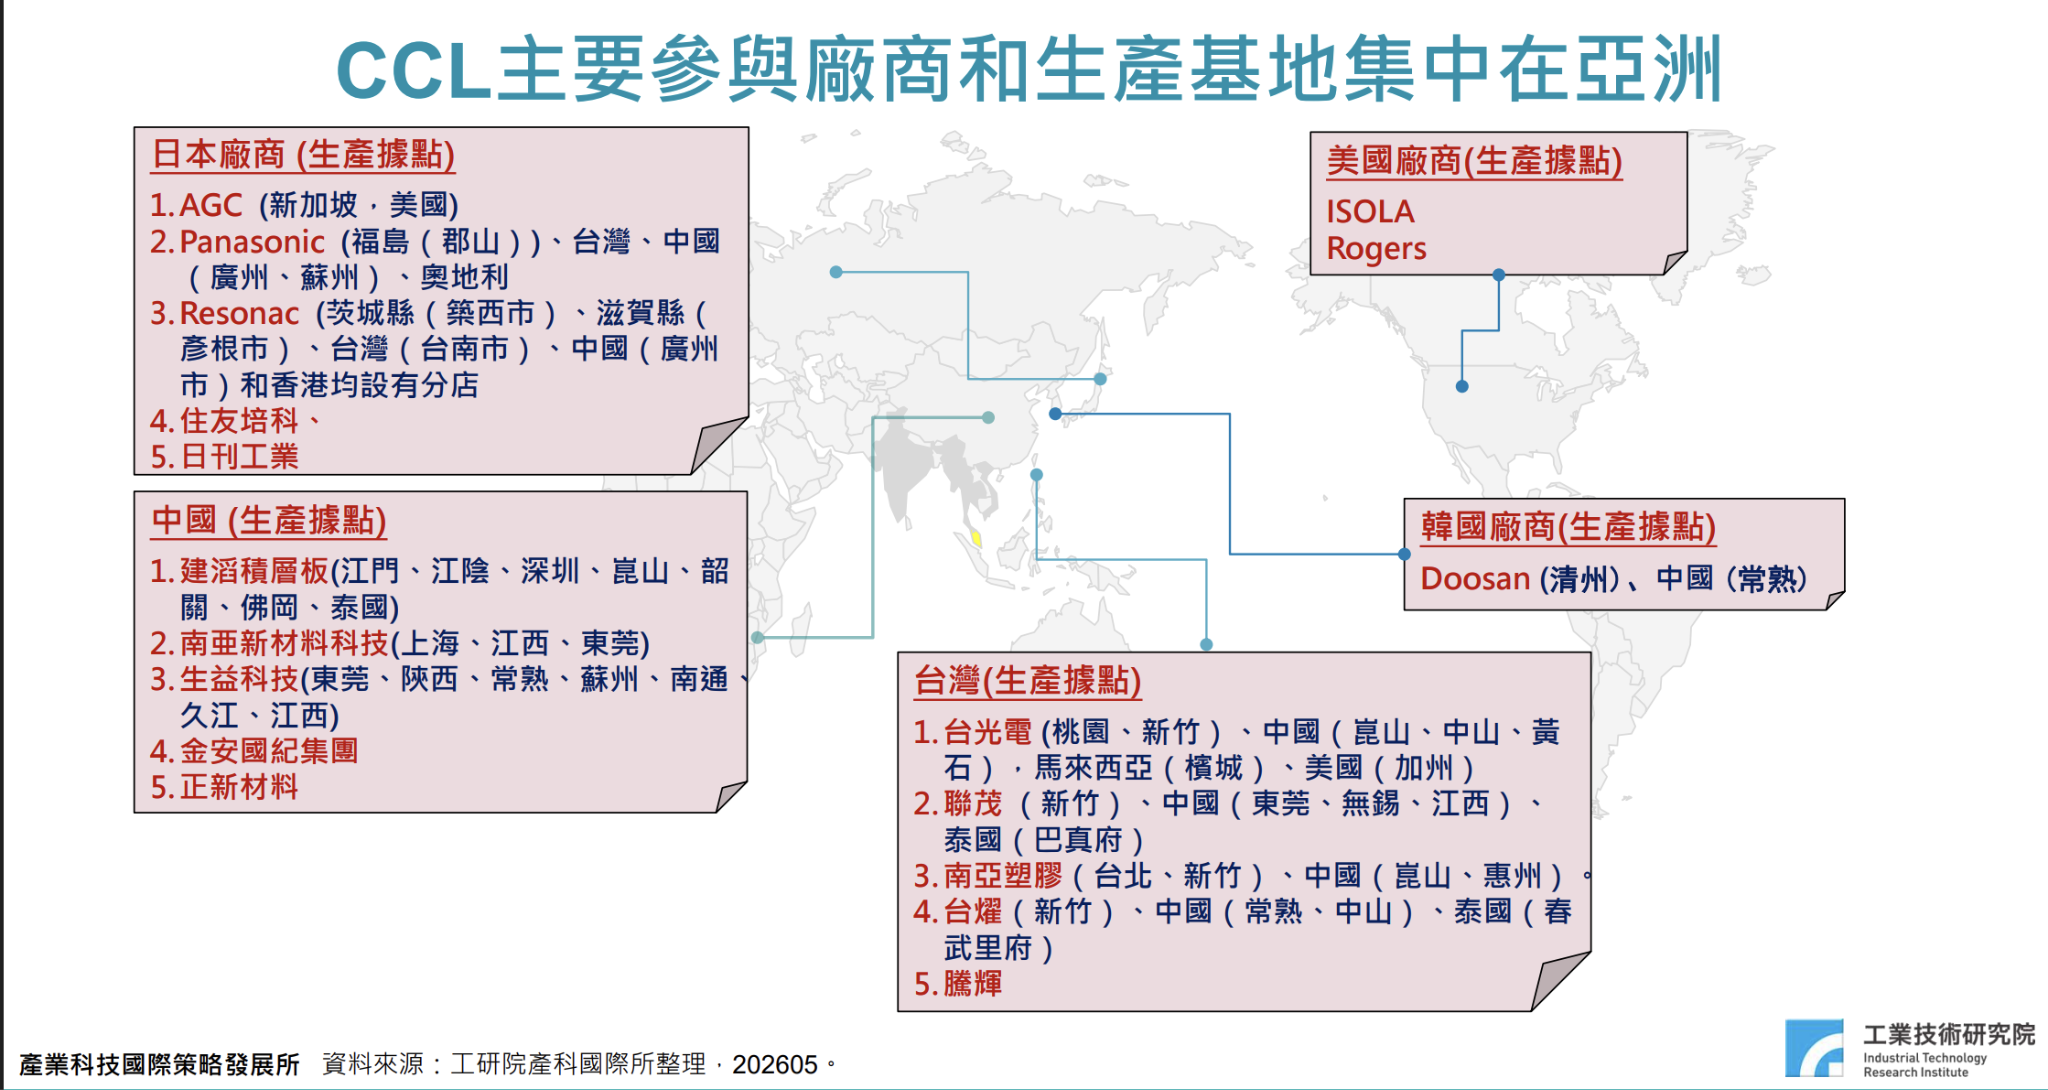
M7 到 M10 的世代切換,本質上是訊號物理逼出來的必然——當你設計 224G PAM4 的板子,CCL 等級不是選擇題,而是物理門檻。對 R&D 與採購團隊而言,三件事必須提早做:
eCloud 在高速 PCB(含 M7/M8/M9 等級板材)、HDI 多階堆疊與 AI 伺服器專案上累積了豐富經驗。下一個高速專案規劃中?歡迎與我們的工程團隊聯繫,在 layout 階段就取得 DFM 預審與材料選型建議,把訊號完整性與料源風險降到最低。