前言:當摩爾定律遇上 AI 巨浪
2025 年,我們正站在運算歷史的轉折點。對於身處台灣資通訊(ICT)產業核心的工程師而言,無論你是負責 PCB Layout 的佈線專家、鑽研散熱機構的熱流工程師、還是埋首於 Verilog 的 IC 設計師,這波由生成式 AI(Generative AI)掀起的浪潮,都不僅僅是規格的升級,而是一場對「運算架構」的徹底重構。
過去,我們習慣於 CPU 主導的世界,摩爾定律(Moore‘s Law)穩定地為我們帶來效能紅利。然而,當兆級參數(Trillion Parameters)的模型成為常態,傳統的馮·諾伊曼架構(Von Neumann Architecture)已撞上了物理牆。我們看到的不再是單純的時脈提升,而是異質運算(Heterogeneous Computing)的全面爆發:CPU、GPU、TPU 三足鼎立,各自在不同的戰場上廝殺與合作。
本報告將為台灣的工程社群——從 RD、研究人員到學生——提供一份詳盡的技術指南。我們將深入探討這三種處理器的本質差異,剖析 NVIDIA Blackwell 與 Google Trillium 的架構秘密,並直面 224G SerDes 的 PCB 設計挑戰、CoWoS 先進封裝的良率瓶頸,以及液冷散熱與垂直供電的實作難題。這不僅是技術分析,更是對台灣供應鏈與工程師職涯發展的深度觀察。
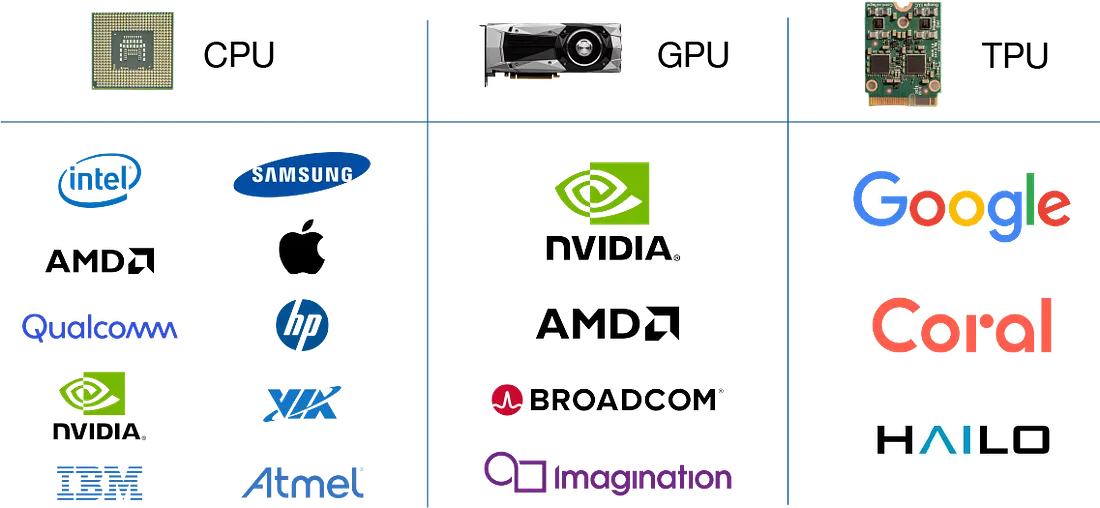
1. 核心架構解密:CPU、GPU 與 TPU 的本質差異
在深入最新的晶片大戰之前,我們必須回到最底層的「第一原理」:為什麼我們需要這麼多種處理器?它們在處理資料的哲學上有何不同?
1.1 CPU:通用運算的指揮官,而非運算苦力
CPU(Central Processing Unit,中央處理器)的設計初衷是「通用性」(Generality)。無論是執行作業系統的核心排程、處理資料庫的複雜查詢,還是執行一段簡單的 Python 腳本,CPU 都能勝任。
- 標量運算(Scalar Processing)與低延遲: CPU 的核心架構是為了極小化單一指令的執行時間(Latency)而優化的。它擁有巨大的快取記憶體(Cache)和極其複雜的控制邏輯(Control Logic),例如分支預測(Branch Prediction)和亂序執行(Out-of-Order Execution)。這些機制是為了讓 CPU 在面對充滿條件判斷(if-else)的程式碼時,能夠保持流暢。
- 馮·諾伊曼瓶頸: 然而,在深度學習的訓練過程中,我們需要的是對海量數據進行重複且單調的矩陣乘法。CPU 將大量的電晶體預算花在了控制邏輯和快取上,真正用於算術邏輯單元(ALU)的面積佔比極低。這導致 CPU 在處理大規模平行運算時,受限於記憶體頻寬和運算密度的不足,效率極低。
Source: Intel
1.2 GPU:從像素渲染到吞噬平行世界的巨獸
GPU(Graphics Processing Unit,圖形處理器)的崛起,是運算史上最美麗的意外之一。原本為了處理 3D 遊戲中數百萬個像素點的渲染而設計的 SIMT(Single Instruction, Multiple Threads)架構,竟完美契合了神經網路的需求。
- 向量運算(Vector Processing)與高吞吐量: GPU 擁有成千上萬個小型核心。與 CPU 不同,GPU 的設計哲學是「吞吐量導向」(Throughput-Oriented)。它透過同時執行成千上萬個執行緒(Threads)來隱藏記憶體存取的延遲。當一組執行緒在等待記憶體數據時,GPU 會瞬間切換到另一組執行緒繼續運算,從而保持 ALU 的滿載。
- 通用性與專用性的平衡: 隨著 NVIDIA 推出 CUDA(Compute Unified Device Architecture),GPU 從單純的繪圖卡進化為 GPGPU(General-Purpose GPU)。NVIDIA 在最新的 Blackwell 架構中,不僅強化了 FP8/FP4 等低精度運算的支援,還保留了相當程度的通用性,使其既能訓練 AI 模型,也能進行科學模擬。

Source: Nvidia
1.3 TPU:為矩陣而生的領域專用架構(ASIC)
Google 的 TPU(Tensor Processing Unit,張量處理器)則是徹底的「領域專用積體電路」(ASIC)。如果說 CPU 是瑞士刀,GPU 是電鋸,那麼 TPU 就是為了切開神經網路這塊硬骨頭而打造的高精密雷射刀。
- 脈動陣列(Systolic Array): 這是 TPU 與 CPU/GPU 最本質的區別。在傳統架構中,數據需要頻繁地在暫存器(Register)和記憶體之間搬運。而在 TPU 的脈動陣列中,數據像血液在血管中流動一樣,有節奏地流過運算單元陣列。
- 運作機制: 權重(Weights)被預先載入並固定在陣列中,輸入數據(Activations)從陣列的一端流入,在流動過程中與權重進行乘加運算(MACs),並將部分和(Partial Sums)傳遞給下一個單元,最終從另一端流出結果。
- 極致能效: 這種設計大幅減少了對記憶體的讀寫次數(Memory Access),從而顯著降低了功耗並提高了運算密度。這也是為什麼 Google 敢於宣稱 TPU 在每瓦效能(Performance per Watt)上優於 GPU 的核心物理基礎。
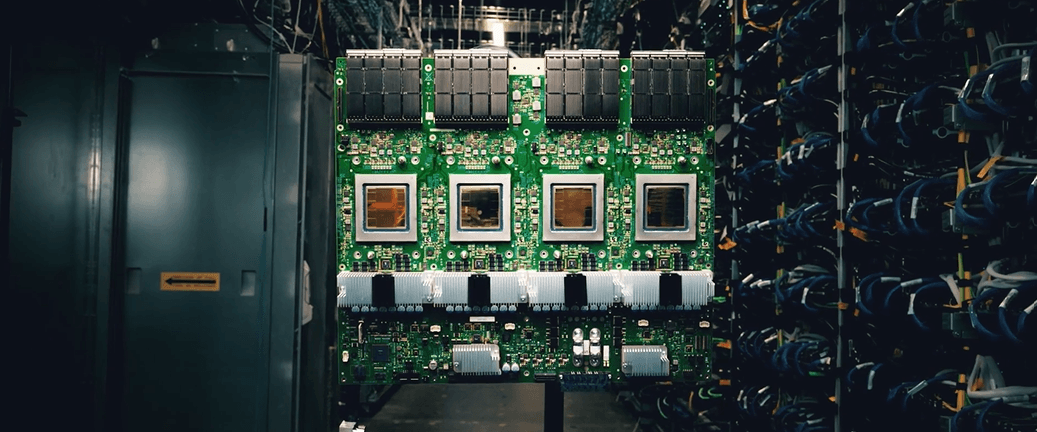
Source: Google
1.4 架構對比總結
| 特性 | CPU (中央處理器) | GPU (圖形處理器) | TPU (張量處理器) |
| :--- | :--- | :--- | :--- |
| 設計哲學 | 通用性、複雜邏輯控制 | 大規模平行、高吞吐量 | 矩陣運算專用、確定性延遲 |
| 運算原語 | 標量 (Scalar) | 向量 (Vector) | 矩陣/張量 (Matrix/Tensor) |
| 硬體架構 | MIMD (多指令多數據) | SIMT (單指令多執行緒) | Systolic Array (脈動陣列) |
| 記憶體存取 | 重度依賴大容量 Cache | 依賴 HBM 頻寬與執行緒切換 | 數據重用 (Data Reuse) 極大化 |
| 主要瓶頸 | 記憶體頻寬、控制邏輯開銷 | 記憶體容量 (HBM)、功耗 | 模型靈活性、開發門檻 |
| 代表產品 | Intel Xeon, AMD EPYC | NVIDIA H100/B200, AMD MI300X | Google TPU v5p/v6 (Trillium) |
2. 2025 硬體軍備競賽:Blackwell、Trillium 與 MI300X 的巔峰對決
2025 年是 AI 硬體的「軍備競賽」元年。隨著模型參數突破兆級,單晶片的效能已不足以支撐,現在的競爭是「系統級」的戰爭。
2.1 NVIDIA Blackwell (B200/GB200):暴力美學的極致
NVIDIA 的 Blackwell 架構(B100/B200)展現了其在通用 AI 加速領域的統治力。這不僅僅是一顆晶片,而是一個龐大的運算平台。
- 雙晶片封裝(Dual-Die Design): 摩爾定律放緩,單顆晶片的面積受限於光刻機的光罩尺寸(Reticle Limit, 約 858mm²)。為了追求極致效能,NVIDIA 在 B200 上採用了 Chiplet 設計,將兩顆全尺寸的 GPU Die 封裝在一起。
- NV-HBI 互連: 這兩顆 Die 之間透過頻寬高達 10 TB/s 的 NV-HBI(High Bandwidth Interface)連接。這個頻寬大得驚人,使得軟體層面完全感覺不到這是兩顆晶片,它表現得就像一顆擁有 192GB HBM3e 記憶體的超級 GPU。
- FP4 精度與 Transformer Engine: 這是 B200 的殺手鐧。透過第二代 Transformer Engine,B200 支援 FP4(4-bit Floating Point)精度。這意味著在相同的記憶體頻寬下,吞吐量可以比 FP8 翻倍,對於推論(Inference)任務來說是巨大的優勢。
- NVL72 機櫃與銅纜互連: 在 GB200 NVL72 系統中,NVIDIA 做了一個大膽的決定——在機櫃內部使用銅纜(Copper)而非光纖進行 NVLink 互連。
- 背板設計: 這將 72 顆 GPU 連接成一個巨大的單一邏輯 GPU。這種設計大幅降低了功耗和成本(銅纜比光模組便宜且省電),但也對機櫃背板(Backplane)的訊號完整性(SI)提出了地獄級的挑戰。
2.2 Google TPU v6 (Trillium):垂直整合與光學交換的逆襲
Google 的第六代 TPU(代號 Trillium)走了一條與 NVIDIA 截然不同的道路。Google 不賣晶片,賣的是「服務」與「算力」,這讓他們在架構設計上更能針對自家資料中心進行最佳化。
- 光路交換(OCS, Optical Circuit Switching): 這是 Google TPU Pods 最大的護城河。傳統的 GPU 集群依賴電訊號交換機(Infiniband 或 Ethernet),需要昂貴的光電轉換模組。Google 自研了 OCS,透過微機電系統(MEMS)反射鏡,直接在光層面上動態重構 TPU 之間的連線。
- 優勢: 這使得 TPU 集群可以極快地改變拓撲結構(Topology),並且在某個節點故障時,OCS 可以物理上繞過該節點,實現極高的系統可用性。這對於動輒數月的大型模型訓練至關重要。
- 能效優先: Trillium 的單晶片峰值算力(Peak FLOPS)或許不如 B200 驚人(TPU v6e 的 INT8 算力約 1836 TOPS,而 B200 高達 9000 TOPS),但在「每瓦效能」上,Google 宣稱 Trillium 比上一代 v5e 提升了 67%。
- HBM 與互連: Trillium 配備了 32GB HBM,頻寬提升至 1600 GB/s,晶片間互連(ICI)頻寬達到 800 GB/s。雖然規格上看似落後於 B200,但 Google 的策略是依靠其強大的軟體堆疊(JAX/XLA)和大規模集群(Scale-out)能力來彌補單點效能的差距。
2.3 AMD MI300X 與 Intel Gaudi 3:性價比與開放生態的突圍
- AMD MI300X: AMD 採取了極致的堆疊策略。MI300X 採用 CDNA 3 架構,透過 3D Hybrid Bonding 將運算核心(XCD)堆疊在 I/O Die 之上。它最大的賣點是 192GB HBM3 的超大記憶體容量和 5.3 TB/s 的頻寬。對於記憶體頻寬受限(Memory-Bound)的 LLM 推論任務(如 Llama 3 70B),MI300X 往往能提供比 H100 更好的性價比。
- Intel Gaudi 3: Intel 雖然在 GPU 戰場失利,但 Gaudi 3 走出了一條獨特的路。它放棄了專有的互連協議,直接在晶片上整合了大量 200GbE RoCE 乙太網路介面。這意味著客戶可以使用標準的乙太網路交換機來組建集群,大幅降低了網路建置成本,適合預算敏感的企業用戶。
3. PCB Layout 工程師的極限挑戰:224G SerDes 與訊號完整性
對於台灣的硬體研發團隊,特別是 PCB Layout 工程師和 SI(Signal Integrity)模擬專家來說,AI Server 的規格升級是一場惡夢。當傳輸速率從 112G PAM4 邁向 224G PAM4,PCB 上的每一微米誤差都可能成為致命傷。
3.1 224G SerDes:物理層的泥沼
在 224 Gbps 的速率下,訊號在 PCB 銅箔上的傳輸如同在泥沼中奔跑。
- 板材大戰(Megtron 8 vs. Megtron 7): 過去在 100G/400G 交換機上常用的 Panasonic Megtron 6 甚至是 Megtron 7,在 224G 時代已顯得力不從心。
- 介質損耗(Df): 為了將插入損耗(Insertion Loss)控制在每英吋 1dB 以內(Nyquist頻率下),設計端必須採用 Df 值更低的材料,如 Panasonic Megtron 8、AGC Nelco Meteorwave 8000 或 Isola Tachyon 100G。這些材料的 Df 值通常需低於 0.0015。
- 銅箔粗糙度(Surface Roughness): 隨著頻率升高,集膚效應(Skin Effect)使得電流僅在導體表面極薄的一層傳輸。傳統銅箔的表面粗糙度會造成巨大的導體損耗。現在必須指定使用 HVLP(Hyper Very Low Profile) 甚至更高等級的銅箔,其表面粗糙度 Rz 可能小於 1.5 微米。
3.2 Via Stub 的夢魘與背鑽工藝
在 Layout 設計中,Via(導通孔)是訊號換層的必要結構,但未使用的 Via Stub(殘樁)是高頻訊號的殺手。
- 天線效應與諧振: Stub 會形成開路傳輸線,在高頻下產生強烈的諧振(Resonance Dip),導致特定頻率的訊號被完全吃掉。
- 背鑽(Backdrilling)的極限: 為了消除 Stub,PCB 廠必須進行背鑽。
- IEEE 802.3df 規範: 針對 224G 應用,建議的 Stub 長度必須小於 6 mil(約 0.15mm),甚至有些設計要求控制在 5 mil 以內。
- 公差挑戰: 一般 PCB 廠的背鑽深度公差約為 ±2 mil 到 ±4 mil。這意味著 Layout 工程師在設計疊構(Stack-up)時,必須在訊號層與下方的參考層之間預留足夠的空間,否則過度背鑽會切斷內部連線,鑽不夠深則 Stub 過長影響 SI。這考驗著台灣 PCB 供應鏈(如欣興、金像電)的精密製程能力。
3.3 佈線與串擾(Crosstalk)
- Skip Layer Routing: 為了減少 Via Stub 的影響並降低損耗,現在的設計傾向使用 Skip Layer(跳層) 佈線,例如從 Layer 1 打孔直接連到 Layer 3,而非穿過整個板厚。或者直接採用 HDI(高密度互連) 的盲埋孔技術,雖然成本高昂,但能有效消除 Stub。
- 玻纖效應(Fiber Weave Effect): 224G 訊號對 PCB 基材中玻璃纖維的編織方式極度敏感。如果差分對的一條線走在玻纖束上(Dk較高),另一條走在樹脂上(Dk較低),會導致兩者傳播速度不同,產生偏斜(Skew)。解決方案是使用 Spread Glass(扁平玻纖布) 或將走線旋轉一個小角度(Zig-zag routing)。
4. 半導體製程與先進封裝:CoWoS 的良率之戰
台積電的 CoWoS(Chip-on-Wafer-on-Substrate)技術是這波 AI 浪潮的物理基礎,也是目前產能的瓶頸所在。對於半導體製造與封測工程師,理解 CoWoS-S 與 CoWoS-L 的差異至關重要。
4.1 CoWoS-S vs. CoWoS-L:突破光罩極限
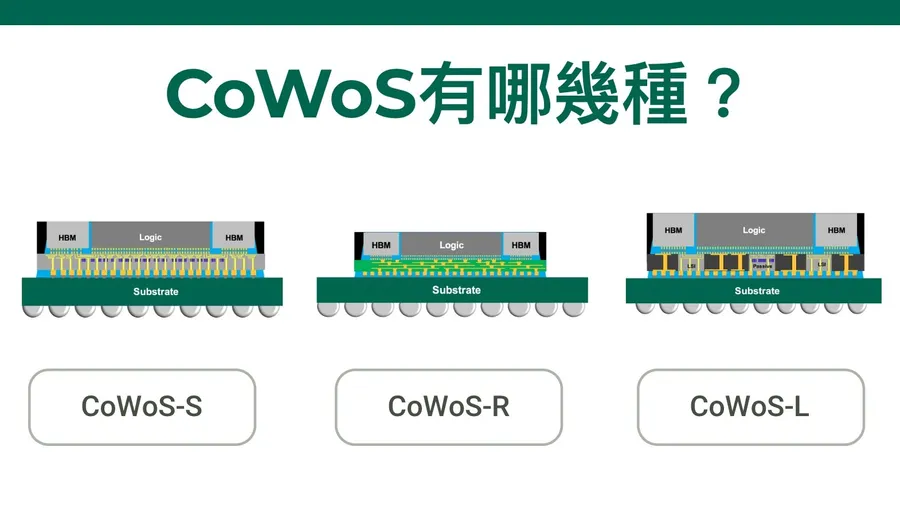
- CoWoS-S(Silicon Interposer): 這是 NVIDIA H100 使用的成熟技術。它使用一片巨大的矽中介層來連接 GPU 和 HBM。
- 限制: 矽中介層是透過光刻製程製造的,受限於光罩尺寸。雖然台積電可以透過拼接(Stitching)技術做出超過光罩極限的中介層(如 3 倍光罩尺寸),但矽片越大,良率越低,且極易碎裂。這限制了封裝的總面積。
- CoWoS-L(Local Silicon Interconnect): 這是 Blackwell(GB200)採用的技術,也是造成初期良率波動的關鍵。
- 架構創新: CoWoS-L 放棄了全矽中介層,改用有機中介層(Organic Interposer)作為基底,僅在 GPU 與 HBM、GPU 與 GPU 之間需要高密度互連的地方,嵌入局部的矽橋(LSI, Local Silicon Interconnect)。
- 優勢: 有機中介層可以做得非常大(超大尺寸封裝),且成本較全矽中介層低,適合整合多顆 Chiplet。
4.2 LSI Bridge 與 CTE Mismatch 的戰爭
CoWoS-L 雖然解決了面積問題,卻帶來了新的物理難題,這是近期台灣封測供應鏈(OSAT)最頭痛的問題。
- 熱膨脹係數(CTE)失配: 一個 CoWoS-L 封裝體包含了 GPU Die(矽)、LSI Bridge(矽)、有機中介層(聚合物/銅)、以及底部的基板。這些材料的 CTE 差異巨大。
- 翹曲(Warpage)與斷裂: 在封裝的回焊(Reflow)高溫過程中,不同材料的膨脹速度不同,會導致嚴重的翹曲。這可能導致極其微小的 LSI 橋接點(Micro-bumps)斷裂或位移。特別是 Blackwell 需要透過 LSI 橋接兩顆 GPU Die,對準精度(Alignment Accuracy)要求極高。一旦發生偏移,10 TB/s 的互連就會失效。
- Underfill(底部填充)挑戰: 由於 LSI Bridge 與周圍有機材料的間隙極小,如何確保 Underfill 膠材能均勻流動且無氣泡(Void-free),也是製程上的一大挑戰。
5. 電源完整性與散熱革命:打破物理熱牆
隨著 NVIDIA B200 的 TDP 突破 1000W 甚至 1200W,傳統的供電和散熱方案已宣告失效。這為台灣的電源供應器與散熱模組廠商(如台達電、光寶、雙鴻、奇鋐)帶來了巨大的機會與挑戰。
5.1 垂直供電(Vertical Power Delivery, VPD)
在傳統的橫向供電(Lateral Power Delivery)中,電流需經過長距離的 PCB 銅箔從 VRM(電壓調節模組)流向 GPU。
- IR Drop 的挑戰: 當電流超過 1000A 時,即便 PCB 銅箔再厚,路徑上的 I²R 損耗(銅損)也會產生顯著的電壓降(IR Drop)和熱量。這不僅浪費能源,還會導致 GPU 電壓不穩。
- VPD 解決方案: 以 Vicor 為代表的廠商推動了 VPD 架構。將電源模組直接放置在 GPU 的正下方(PCB 背面),電流垂直穿過 PCB 給 GPU 供電。
- 優勢: 這將 PDN(Power Delivery Network)阻抗降至最低,大幅減少傳輸損耗。
- PCB 設計難度: 這使得 PCB 設計變得極其複雜,因為要在 GPU 正下方佈置大量的電源過孔(Power Vias),同時還要避開高速訊號過孔,對 PCB 的層數和鑽孔精度要求極高,這是台灣 PCB 廠的高階製程護城河。
5.2 液冷革命:從選配變標配
GB200 NVL72 的推出宣告了氣冷時代在高效能運算領域的終結。
- Cold Plates(水冷板): 冷板必須精密加工以覆蓋 GPU、HBM 及 VRM。內部的微流道(Micro-channels) 設計是散熱效率的關鍵,需要極高的 CNC 加工精度和真空釺焊技術以防漏液。台灣廠商如雙鴻(Auras) 和奇鋐(AVC) 在此領域擁有深厚的專利佈局。
- CDU(Coolant Distribution Unit): 這是液冷系統的心臟,負責監控流量、壓力與溫度。台灣廠商正在從單純的零組件供應商轉型為系統整合商,提供 Manifold(分歧管)和 CDU 的整體解決方案。
- UQD(Universal Quick Disconnect,快拆接頭): 這是液冷系統中最關鍵的「小零件」。為了防止在維護時冷卻液洩漏,UQD 必須具備極高的可靠性和防漏設計。目前市場主要由 Stäubli 等外商主導,但台灣廠商如富世達(Fositek) 正在積極切入此高毛利領域,力求通過 NVIDIA 的認證。
6. 軟體定義硬體:CUDA、JAX 與編譯器戰爭
硬體只是入場券,軟體才是護城河。對於台灣的軟體工程師和學生來說,選擇學習哪種技術堆疊(Tech Stack)關乎未來的職涯發展。
6.1 CUDA:NVIDIA 的絕對防線
CUDA 已經發展了近 20 年,擁有最豐富的算子庫(Libraries)和開發者社群。大多數現有的 AI 模型和論文程式碼都是基於 PyTorch + CUDA 開發的。這形成了強大的路徑依賴(Path Dependency),使得競爭對手難以在短期內撼動其地位。
6.2 JAX 與 XLA:Google 的函數式編程反擊
PyTorch 在 TPU 上的運行(透過 PyTorch/XLA)歷史上體驗並不完美,除錯(Debugging)困難且常有性能折損,主要因為 XLA 的 Lazy Execution 模式與 PyTorch 的 Eager Mode 本質上的衝突。
因此,Google 大力推廣 JAX。
- JAX 的優勢: JAX 是一個基於函數式編程(Functional Programming)的框架,它與 XLA(Accelerated Linear Algebra)編譯器結合得天衣無縫。在 TPU 上,JAX 通常能比 PyTorch 發揮出更高的效能,特別是在大規模並行訓練(SPMD)上。JAX 的
jit (Just-In-Time) 編譯能將 Python 函數轉換為極致優化的 XLA HLO (High Level Operations) 代碼。
6.3 Kernel 開發:Triton vs. Pallas
對於追求極致效能的 AI 工程師,撰寫自定義 Kernel 是必經之路。
- Triton: OpenAI 推出的語言,讓開發者可以用類似 Python 的語法寫出高效的 GPU Kernel,打破了 CUDA C++ 的高門檻。Triton 現在是 PyTorch 2.0 的預設編譯後端(Inductor),生態系日益壯大。
- Pallas: Google JAX 推出的 Kernel 語言,允許開發者針對 TPU(和 GPU)撰寫底層 Kernel。Pallas 提供了對 TPU 記憶體階層(HBM -> VMEM -> SMEM)的精細控制。
- 難度對比: Pallas 的學習曲線極其陡峭,需要開發者對 TPU 的硬體管線(Pipeline)和 DMA 傳輸有深刻理解,目前主要由 Google 內部和頂級研究機構使用。
7. 台灣工程師的職涯與市場觀察
7.1 系統廠(ODM)的價值重估
過去,台灣的系統組裝廠(如廣達、緯穎、鴻海)常被視為毛利微薄的代工廠。但在 AI Server 時代,情況發生了逆轉。
- Rack-Scale Integration: 現在的 AI Server 不再是單機出貨,而是以「機櫃(Rack)」甚至「Pod」為單位。GB200 NVL72 一個機櫃的造價高達數百萬美元,設計難度涵蓋了液冷流體力學、高壓配電(Busbar)、高速訊號佈線。ODM 廠掌握了這些複雜的系統整合能力,成為了 CSP(雲端服務供應商)不可或缺的夥伴。
- 薪資結構變化: 頂級的 AI 系統工程師在 O
