2026年3月24日
隨著二零二六年台北國際電腦展(Computex 2026)的腳步日益臨近,全球半導體與系統整合產業正處於一個關鍵的技術轉折點。對於台灣的研發工程師與設計團隊而言,二零二六年不僅僅是硬體更新的一年,更是人工智慧(AI)運算從單純的晶片競爭轉向「機櫃級」(Rack-scale)系統整合的元年。 在 AI 伺服器與高效能運算(HPC)需求的推動下,印刷電路板(PCB)的設計範式正在經歷前所未有的劇烈變革。這場變革涵蓋了極低損耗材料的導入、超高層數的工藝突破、三維空間的熱管理挑戰,以及全新高速協議下的訊號完整性要求。二零二六年的 PCB 產值預計將攀升至一千零五十二億美元的新高,背後的核心動能正是來自於這些被系統大廠「悄悄導入」的高階技術規格。
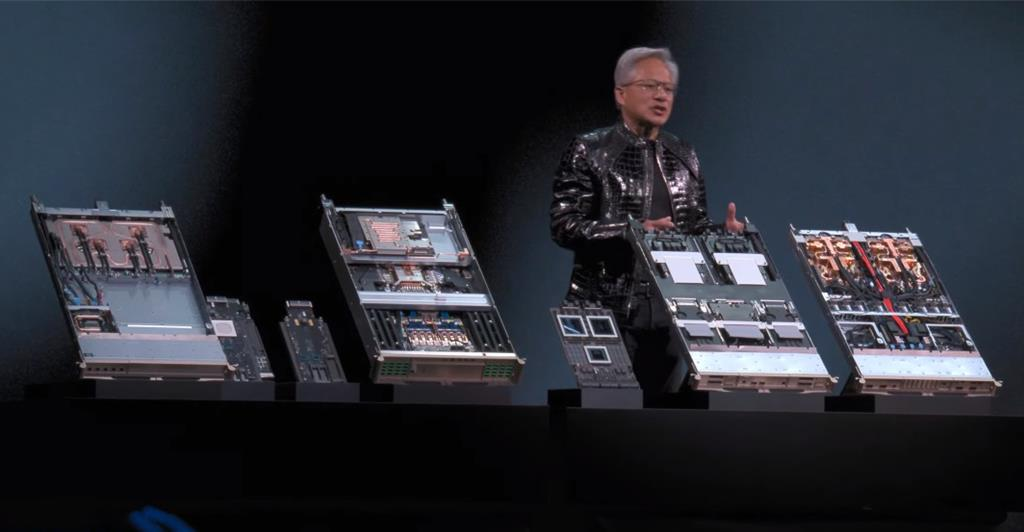
在二零二五年以前,人工智慧硬體市場主要由 NVIDIA 的 GPU 供應能力所主導。然而,進入二零二六年後,產業焦點已顯著移轉至「系統整合」與「大規模交付」。台灣的電子代工巨頭(ODM)如鴻海(Foxconn)、廣達(Quanta)、緯創(Wistron)以及原本在第一波 AI 浪潮中表現相對沉寂的和碩(Pegatron)、仁寶(Compal)與英業達(Inventec),正積極展開技術反攻。
這種戰略位移被產業分析師稱為「AI 的第二階段」。在這一階段,單一晶片的效能提升已不足以滿足兆級參數大型語言模型(LLM)的訓練需求。系統廠的競爭核心在於 L10(系統組裝)與 L11(機櫃級整合)的交付能力。尤其是 NVIDIA 的 Vera Rubin (R200) 平台,將「機櫃」視為最小的出貨單位,這使得 PCB 的設計必須與液冷架構、48V DC 高效配電系統以及極高密度的中背板(Midplane)深度耦合。
 表一:二零二六台灣系統大廠 AI 核心戰略
| 廠商名稱 | 二零二六核心戰略目標 | 關鍵技術投資與產能佈局 | | :--- | :--- | :--- | | 鴻海 (Foxconn) | 主導 Vera Rubin NVL72 平台開發 | 預計爭取 60% AI 伺服器市佔,強化 L10/L11 整合 | | 廣達 (Quanta) | 聚焦超大規模雲端服務提供商 (CSP) 訂單 | 推動全液冷機櫃方案,擴大伺服器營收比重 | | 緯創 (Wistron) | 維持高階 GPU 基板 (UBB) 領導地位 | 營收預計突破兩兆台幣,深度對接 NVIDIA 供應鏈 | | 英業達 (Inventec) | 轉向 ASIC 與 AMD 生態系 | 鎖定 Google TPU 訂單,ASIC 營收佔比目標 >50% |
這種競爭態勢迫使研發工程師必須重新思考硬體層級的設計。二零二六年的 AI 伺服器已成為「移動式的伺服器機房」,這對 PCB 的耐熱性、大電流負載以及長期運行的穩定性提出了極限挑戰。
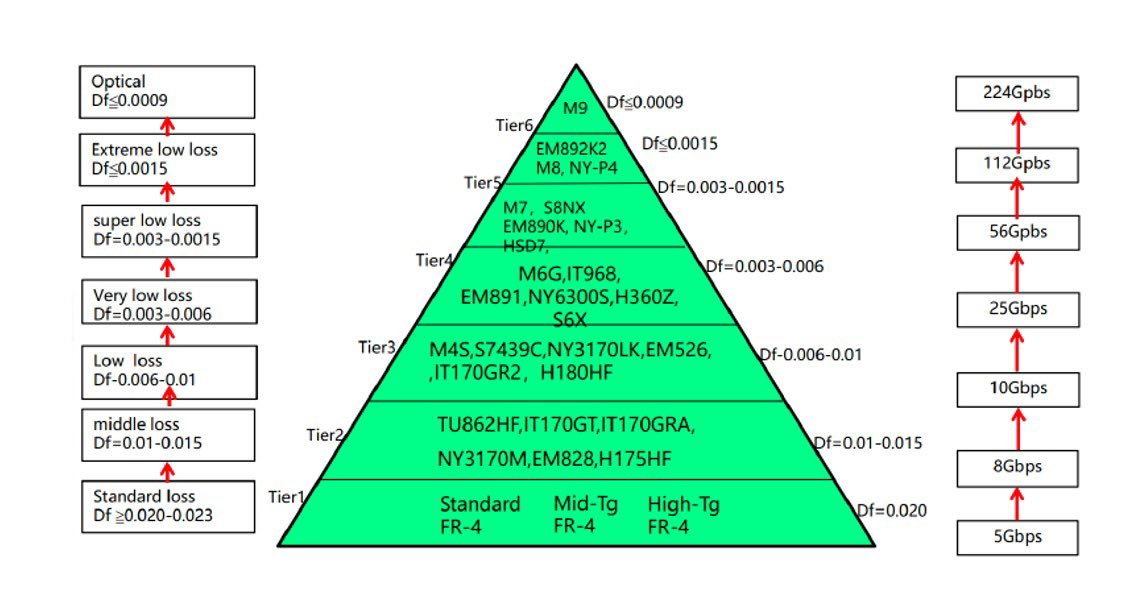
在高速訊號傳輸的領域,材料決定了設計的上限。隨著 112G 與 224G 串行器(SerDes)技術的普及,傳統材料 FR-4 早就被淘汰,甚至二零二四年的主力材料 Megtron 6 (M6) 也已無法完全滿足下一代 800G 與 1.6T 網路交換器以及 Vera Rubin 平台的要求。
在 Computex 2026 現場,研發工程師將會觀察到 Megtron 7 (M7) 與 Megtron 8 (M8) 材料的全面滲透。Megtron 8 作為二零二六年的旗艦級材料,其介電常數(Dk)約為 3.1,散逸因子(Df)在 14 GHz 下驚人地降至 0.0012。這意味著在相同的佈線長度下,Megtron 8 能提供更乾淨的眼圖(Eye Diagram)品質,並有效減少對重定時器(Retimer)的需求,進而降低系統整體的功耗與延遲。
更值得注意的是,NVIDIA 的 R200 世代將開始導入 M9 等級 的極致損耗材料。根據供應鏈的調查,台光電(EMC)目前在 M9 等級的 CCL 市場中佔據主導地位,因為其產品已在 R200 系列的 Midplane 中獲得驗證。這種中板採用了史無前例的 44 層 高層數(HLC)設計,並捨棄了傳統的電纜連接方式,改以 PCB 走線直接對接運算模組與交換模組,這被稱為「Cableless」設計。這種轉變不僅是為了空間優化,更是為了在極高頻環境下維持阻抗的連續性。
二零二六年將被視為「玻璃基板」技術從研發走向商業化應用的關鍵轉折點。隨著 AI 晶片的尺寸(Reticle Size)不斷擴大,以及 HBM 堆疊數量的增加,傳統的 ABF 有機載板面臨嚴重的物理極限,尤其是熱膨脹係數(CTE)不匹配導致的翹曲(Warpage)問題。
英特爾(Intel)在二零二六年初展示了業界首款 10-2-10 結構 的玻璃基板封裝解決方案。這項技術的核心在於使用 800 微米厚的玻璃作為核心層,並在上下兩側各布建 10 層重佈線層(RDL)。玻璃基板具備與矽晶片極為接近的熱膨脹係數,這使得它在極大尺寸(如 78x77 mm 以上)的封裝中能保持極佳的幾何穩定性,翹曲度控制在 20um 以內。此外,玻璃通孔 (TGV) 技術可實現極高深寬比,使封裝內部的 I/O 密度提升至目前的 5 倍以上。
在傳輸協議與記憶體架構方面,二零二六年的 PCB 設計也迎來結構性革命。
二零二六年是 PCIe 6.0 進入全速布署,且 PCIe 7.0 規範正式確立的一年。這對訊號完整性提出近乎「毫米波等級」的要求。PCIe 6.0 引入了 PAM4 編碼,導致雜訊容限(Noise Margin)大幅縮減,訊號雜訊比(SNR)劣化了約 9.6 dB。工程師必須嚴格控制反射與串擾。二零二六年的設計指南普遍建議將阻抗誤差控制在 7% 以內,甚至部分關鍵走線要求 5% 的極致容差。
記憶體設計也經歷結構性改革。DDR6 標準為了在極高頻率下降低電氣負載,將原本 DDR5 的 64 位元通道架構,重構為四個 24 位元(總頻寬擴展至 96 位元)的平行子通道。這種窄頻、高頻的設計思路,雖然提升了平行處理能力,但也對 PCB 的走線等長要求(Signal Skew)提出了更高的標準。在 DDR6 設計中,DQ 與其對應的 DQS 時鐘訊號之間的電氣延遲誤差必須嚴格控制在 +-5ps 以內。
為了應對這些挑戰,新一代的 CAMM2 (Compression Attached Memory Module) 連接器正迅速取代傳統插槽。CAMM2 採用壓接方式,縮短了記憶體晶片到 CPU 之間的走線長度,消除了傳統插槽帶來的垂直截面阻抗不連續點,這對於 DDR6 邁向 17,600 MT/s 的速率至關重要。
當 GPU 單體功耗突破 1,000 瓦,機櫃功耗達 100kW 以上時,散熱不再是外掛的風扇,而是 PCB 設計的一部分。二零二六年的旗艦級伺服器中,液冷技術(Liquid Cooling)已成為標配而非選項。
電力傳輸的效率直接影響系統營運成本。二零二六年的資料中心正大規模導入 48V DC 機櫃級配電系統,取代傳統的 12V 方案以降低電流損耗(P = I²R)。對於 PCB 工程師來說,VRM(電壓調節模組)必須在極小的空間內完成高效轉換。這意味著 PCB 必須設計厚銅層(3oz 或 4oz 以上)來承載巨大的電流負載,同時利用大面積的銅澆注來輔助散熱。
在電源穩定性方面,DDR6 與高速 SerDes 對電壓漣波(Ripple)極為敏感。研發團隊普遍採用「階梯式去耦電容策略」,甚至導入埋入式電容技術(Embedded Decap)來進一步降低環路電感。
面對 Computex 2026 所揭示的技術浪潮,台灣的研發工程師必須具備跨領域的整合視野。PCB 已不再是「承載零件的板子」,而是系統效能的瓶頸點,也是創新點。
二零二六年的 Computex 將是一個展示台灣研發實力的絕佳舞台。從晶片封裝到 PCB 材料,從液冷架構到高壓電源,台灣研發團隊若能站在這波規格演進的最前沿,必能在全球 AI 生態系中持續扮演不可替代的核心角色。
