2026年3月6日
隨著 AI 模型規模爆炸性增長,Nvidia 與 AMD 的次世代加速器在 2026 至 2027 年迎來前所未有的熱設計功耗(TDP)挑戰 。單晶片功耗高達 2.3 kW,使資料中心散熱成為技術和材料的雙重考驗 。液冷技術雖能有效降低 PUE,但對 PCB 與銅箔基板提出全新物理、化學與機械挑戰 。
全球晶片巨頭在次世代 AI 加速器架構設計上,正迎來一場前所未有的算力與功耗軍備競賽。Nvidia 預計於 2026 年投入量產的 Vera Rubin 平台,為了在硬體規格上全面壓制競爭對手,其單一 GPU(GR100)的 TDP 預估已從原先的 1.8 kW 暴增至 2.3 kW,同時將高頻寬記憶體(HBM4)的系統資料傳輸率提升至 22.2 TB/s。
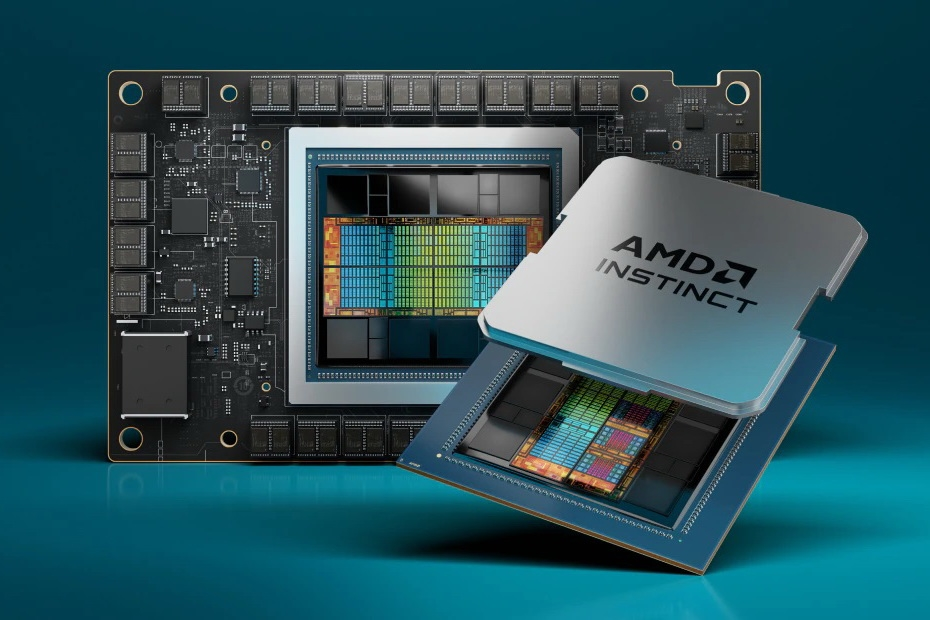
另一方面,AMD 預計於 2026 年下半年推出的 Instinct MI400 系列(包含主攻大規模訓練的 MI455X,以及針對高效能運算的 MI430X),將 HBM4 記憶體容量推升至超越對手的 432 GB,提供 19.6 TB/s 的頻寬,其單晶片 TDP 亦達到約 1.7 kW 的驚人水準。
當這些極端功耗的晶片被整合至機櫃級別(Rack-scale)的系統時,散熱挑戰呈現幾何級數放大。以 Nvidia 規劃的 VR300 NVL576 系統為例,單一機櫃將容納高達 576 顆 Rubin GPU,整體機櫃功耗將超過 600 kW。而 AMD 針對大規模叢集推出的 Helios 系統,單一機櫃整合 72 顆 MI400 加速器,同樣面臨極端的電力與散熱密度考驗。傳統氣冷技術在機櫃密度超過 50 至 60 kW 時,便在物理學與經濟學上失去了可行性,這直接驅動了資料中心全面轉向液冷散熱架構。
表 1:Nvidia 與 AMD 次世代 AI 平台規格對比
| 平台架構 | 預估量產時間 | 單晶片 TDP | 記憶體配置與頻寬 | 機櫃級別系統與功耗 | | :--- | :--- | :--- | :--- | :--- | | Nvidia Vera Rubin (VR200/VR300) | 2026 下半年 | ~2.3 kW | 288 GB HBM4 (22.2 TB/s) | NVL72 / NVL576 (>600 kW) | | AMD Instinct MI400 (MI455X/MI430X) | 2026 下半年 | ~1.7 kW | 432 GB HBM4 (19.6 TB/s) | Helios 系統 (72 顆 GPU) |
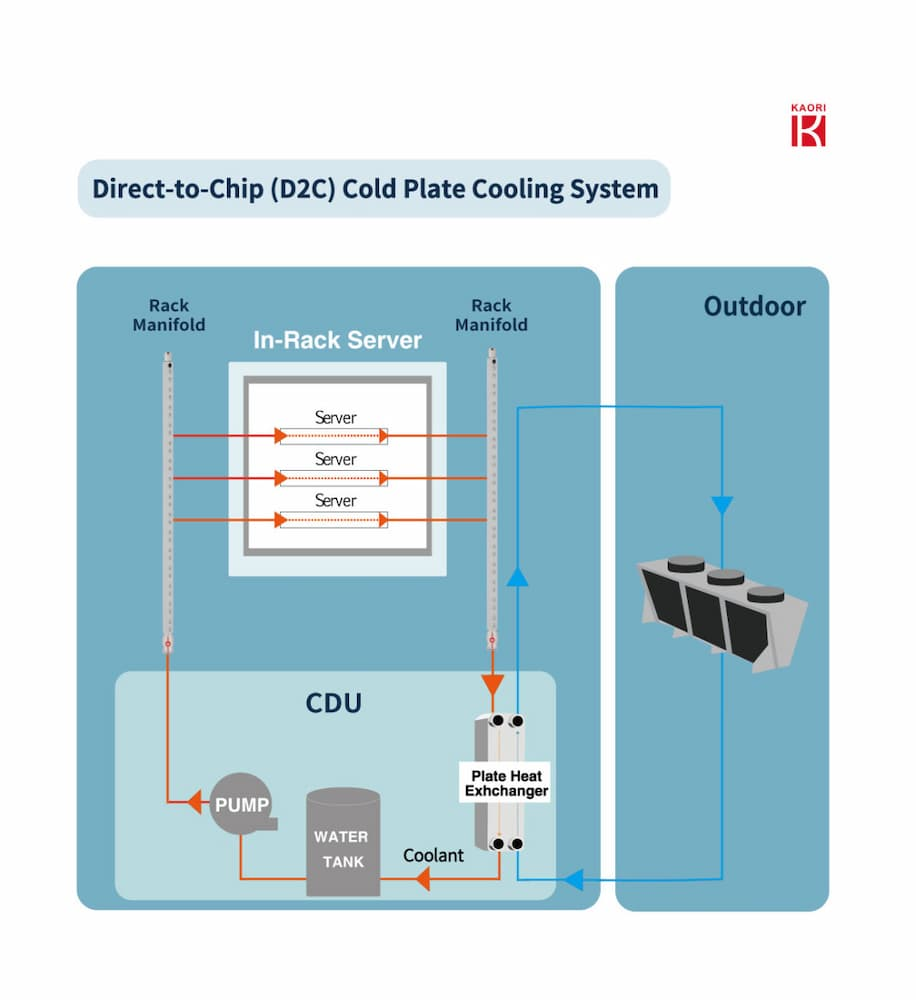
直接晶片液冷(D2C, Direct-to-Chip)是目前市場接受度最高的方案。微通道冷水板直接貼附於 GPU 表面,透過冷卻液循環帶走熱量。然而,這項技術將巨大的機械與熱力學應力,直接轉移到了機構與 PCB 板材的交界面上。
為了壓制 2.3 kW 級別的熱量,液冷系統高壓與熱循環對 PCB 構成龐大應力。開放運算計畫(OCP)規範建議,冷水板的安裝下壓力必須大於 40 psi 以確保導熱效率。這股持續的下壓力,配合極端的高低溫交替,極易引發熱膨脹係數(CTE)的錯配,造成 PCB 變形、BGA 焊點龜裂以及微盲孔斷裂。這迫使 PCB 必須全面轉向具備高剛性、高模量與極低 CTE 的進階基材。
浸沒式冷卻將整台伺服器完全浸泡於非導電介電液中,雖然解決了局部熱點問題,但對 PCB 的化學相容性帶來了嚴峻考驗。最大的隱形殺手是 「導電性陽極絲」(CAF, Conductive Anodic Filament)。在浸沒環境中,液體若發生微量降解或吸收水分,將大幅加速銅離子沿著樹脂與玻璃纖維交界面遷移,導致微短路。
因此,基板樹脂必須具備超過 170°C 的極高玻璃轉化溫度(Tg),以阻斷銅離子遷移路徑。此外,PCB 表面的防焊層(綠漆, LPI)長時間浸泡在化學液中極易發生溶脹或剝離。剝落的微粒會堵塞冷卻系統,引發設備停機。防焊層必須採用交聯密度極高的特殊配方,並嚴格符合 IPC-SM-840 Class H 高可靠度標準。
次世代 AI 伺服器不僅要解決高功耗散熱,還必須應付高達 224 Gbps PAM4(四階脈衝振幅調變)的超高速訊號完整性(Signal Integrity)要求。這對插入損耗(Insertion Loss)提出了極度嚴苛的限制,驅動了銅箔基板(CCL)材料的深層技術革命。
在 AI 伺服器的材料升級潮中,台灣的 CCL 與 PCB 供應商憑藉在超低損耗與無鹵素高頻材料的技術積累,佔據了全球主導地位。面對液冷與高速傳輸挑戰,台廠的市場佈局呈現高度優勢。
表 2:台灣核心 PCB/CCL 供應商技術與市場佈局
| 供應商 (代號) | 核心技術優勢 | 液冷兼容性與高速材料策略 | 全球市場定位與供應鏈地位 | | :--- | :--- | :--- | :--- | | 台光電 (2383) | 第一大無鹵素 CCL 廠,主導 M7/M8 等級超低損耗材料 | 無鹵素配方具極佳化學抗性,高 Tg 抗 CAF,極適用於多層板液冷設計 | 囊括多數 ASIC 專案,為 Nvidia GB200/300 及 AWS/Meta 核心供應商 | | 台燿 (6274) | 專注高頻高速 (HSD) 與高可靠度背板材料 | ThunderClad 系列具備低 CTE 與高 Tg,能承受 D2C 嚴苛熱力學與機械應力 | 廣泛應用於 400G/800G 交換器與 AI 伺服器 OAM/UBB,毛利率強勢 | | 聯茂 (6213) | 推動 PCIe Gen 5/6 升級,領先開發無玻纖 RCC 材料 | RCC 技術消除玻纖效應,從物理結構阻絕 CAF,極適合浸沒式液冷環境 | 成功打入 Intel、AMD 平台及 AI 伺服器 GPU OAM 與 CPU 主機板供應鏈 | | 南亞塑膠 (1303) | 垂直整合電子級環氧樹脂、銅箔與高階 T-Glass 玻纖布 | 旗下 T-Glass 通過認證,為控制高層數 PCB 翹曲及抵抗浸沒熱衝擊的關鍵 | 掌握戰略物資定價權,直接掐住全球高階電子材料供應咽喉 | | 金居開發 (8358) | 專攻高階特殊銅箔,具備次世代 HVLP4 大規模量產能力 | HVLP4 表面粗糙度僅 0.5-1.5μm,支援液冷板極限訊號傳輸並解決集膚效應 | 打破日廠壟斷,產能精準填補全球 HVLP4 的龐大供需缺口 |
對於身處前線的台灣研發工程師(RD)與產品經理(PM)而言,面對 2026 年次世代液冷架構,產品開發思維必須進行根本性轉換:
必須將 「熱-固耦合應力分析」 列為設計最高準則。隨著 D2C 冷水板裝配壓力超過 40 psi,傳統設計流程已無法應對。研發團隊需在初期導入模擬,評估高密度 HDI 板在極限壓力與熱循環下的翹曲風險,並強制採用低 CTE(如 T-Glass)與高模量基材,防範 BGA 焊點機械疲勞。
針對浸沒式冷卻專案,絕對不可沿用氣冷時代的 BOM 表。所有接觸介電液的高分子材料(包含防焊綠漆)皆須遵循 OCP 及 ASTM D3455 規範進行長時間化學相容性測試。PM 應嚴格要求防焊層符合 IPC-SM-840 Class H 標準,杜絕因溶脹剝離引發的系統癱瘓。
因應 224G 傳輸,佈局 M7/M8 等級 CCL 與 HVLP4 銅箔是剛性需求。同時,為防範液冷環境的 CAF 風險,應積極評估台光電、聯茂等大廠的新型無鹵素高 Tg 樹脂,或針對超高密度 OAM 導入 RCC(樹脂塗佈銅箔)材料,從物理根源切斷 CAF 生長路徑。此外,T-Glass 與 HVLP4 恐將面臨嚴重缺貨,PM 必須與供應商提前綁定戰略備料,確保高單價專案順利放量。
總結來看,次世代 AI 伺服器的散熱挑戰正在推動 PCB 材料技術全面升級。液冷技術的普及不僅提升能效,也對材料供應鏈和工程設計提出全新要求。掌握高頻高速、低損耗及高可靠度材料的廠商與研發團隊,將在 2026 年迎來市場競爭的決勝優勢。
