2026年1月22日
隨著生成式人工智慧(Generative AI)從大型語言模型(LLM)向代理型 AI(Agentic AI)與多模態推理(Multimodal Reasoning)演進,全球算力需求已進入指數級增長的軌道。2026 年預計將成為硬體史上的關鍵轉折點,NVIDIA Rubin 平台、AMD Helios 平台以及各類客製化 ASIC 晶片將正式進入大規模量產階段 。這些晶片不僅在製程上邁向台積電 3 奈米節點,更在封裝、互連與散熱架構上推動了「極端協同設計(Extreme Codesign)」的典範轉移 。在這一脈絡下,印刷電路板(PCB)作為承載算力的物理底層,正經歷一場由數據速率與功耗密度暴力推升的技術革命。本報告將深度分析 2026 年 AI 伺服器如何迫使 PCB 規格跨越 28 層以上的高多層門檻,並探討 M7/M8 等等級材料在訊號損耗與熱管理領域的解決方案,同時結合逸雲科技(Cloud-Top)在精密壓合領域的技術優勢,為台灣研發工程師(RD)與學生族群提供系統性的技術見解。
2026 年 AI 伺服器設計的核心邏輯已從「單體計算」轉向「機櫃即電腦(The Rack is the Computer)」。NVIDIA 創辦人黃仁勳在揭示 Rubin 平台時強調,Rubin 平台透過六大晶片子系統的協同優化,旨在將推論代幣成本降低 10 倍,並將 MoE 模型的訓練所需 GPU 數量減少 4 倍 。這種性能的飛躍直接反映在 PCB 的設計複雜度上。
Rubin GPU 採用台積電 3 奈米製程,單顆晶片電晶體數量達到 3360 億個(某些消息來源提的是 Rubin GPU 趨近 336B(3360 億)級別,但正式數據可能因 NDA 或媒體溢出而各有差異。),相較於前代 Blackwell 的 2080 億個增長了 1.6 倍 。如此巨大的電晶體規模意味著極高的輸入/輸出(I/O)密度。為了支持這些 I/O,PCB 必須提供極細的線寬與線距(L/S),通常需達到 25/25 微米甚至更低的規格,這顯著推升了對高密度互連(HDI)與修正型半加成工藝(mSAP)的需求。
Rubin 平台引入了首款自研高效能 Arm CPU「Vera」,具備 88 個自定義 Olympus 核心與 176 個空間多執行緒(Spatial Multithreading) 。Vera CPU 與 Rubin GPU 之間透過速率高達 1.8 TB/s 的 NVLink-C2C 進行互連,這要求 PCB 在 CPU 與 GPU 之間的傳輸路徑上具備近乎零誤差的阻抗一致性。
此外,Rubin 平台將記憶體規格推升至 HBM4,單 GPU 搭載量達 288GB,頻寬驚人地達到 22 TB/s,是前代的 2.8 倍 。HBM4 與 GPU 的 2.5D/3D 封裝對底層載板(Substrate)以及系統主機板(Motherboard)的平整度要求極高。任何微小的 PCB 翹曲(Warpage)都可能導致焊接失效或高速訊號劣化。
| 平台組件 | 關鍵技術參數 (2026) | 對 PCB 的直接影響 | | :--- | :--- | :--- | | Rubin GPU | 336B Transistors, 3nm | 暴力推升佈線密度與 HDI 階數 | | Vera CPU | 88 Olympus Cores, Arm v9.2-A | 需要超高層數的電源分配網路 (PDN) | | HBM4 Memory | 22 TB/s Bandwidth, 288GB | 需要極低介電損耗材料以維持訊號完整性 | | NVLink 6 | 3.6 TB/s GPU-to-GPU | 導致 UBB 板層數突破 28 層 | | ConnectX-9 NIC | 1.6 Tb/s Networking, 200G SerDes | 強制要求使用 M8 或更高階材料 |
隨著傳輸路徑的增加與電源需求的爆炸,AI 伺服器的通用基板(UBB)與加速器模組(OAM)PCB 已全面跨入高多層板(HLC)領域。在 2026 年,28 層板將成為高端 AI 伺服器的標準配置,部分設計甚至達到 40 層至 50 層。
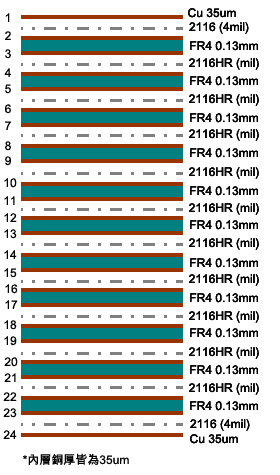
在 PCIe 7.0 (128 GT/s) 與 200G PAM4 訊號共存的環境下,電磁干擾(EMI)與串擾(Crosstalk)是研發工程師最大的敵人 。為了確保訊號完整性(SI),高速差分對通常需要夾在兩個完整接地層(GND)之間,形成嚴格的帶狀線(Stripline)結構 。在 Rubin 平台中,NVLink 走線數量多達數千對,這使得訊號層數大幅增加。
同時,AI 晶片在瞬間負載下的電流需求高達數百安培,電源分配網路(PDN)必須透過增加厚銅層與專用電源層來降低直流電阻(DCR)與電壓降(IR Drop) 。這導致了訊號層與電源層的重疊堆疊,最終推升總層數至 28 層以上。

製造 2.5mm 以上厚度的 28 層 PCB 面臨極大的工藝挑戰。首先是高縱橫比(High Aspect Ratio)的鑽孔與鍍銅。當板厚與孔徑之比超過 15:1 時,電鍍液在孔心中的流動受限,極易導致孔壁銅厚不均,進而影響熱可靠性。
其次,多層板的壓合位準(Registration)精度成為良率的核心。在 28 層的堆疊中,每一層的縮放係數(Scaling)略有不同。若壓合精度不足,內層焊墊(Pad)與孔位發生偏位,輕則增加寄生電容損耗訊號,重則導致斷路 。這正是逸雲科技(Cloud-Top)等專業壓合設備供應商展現價值之處。
為了在性能與成本間取得平衡,2026 年的 AI PCB 普遍採用混合疊層設計。例如,在承載 PCIe 7.0 與 NVLink 6 的核心訊號層使用 M8 等級的高單價超低損耗材料,而在非關鍵訊號層或純電源層則使用 M6 或高 Tg FR4 材料 。這種設計要求壓合製程必須能處理不同材料間的熱膨脹係數(CTE)差異,否則在回流焊過程中極易發生分層(Delamination)。
在 2026 年,PCIe 7.0 成為資料中心內部互連的主流,其奈奎斯特頻率(Nyquist Frequency)高達 32 GHz 。這使得訊號在 PCB 走線中的傳輸面臨極其嚴重的介質損耗(Dielectric Loss)與導體損耗(Conductor Loss)。
傳統的 FR4 材料因其耗散因子(Df)過高(約 0.02),在 10GHz 以上訊號便會迅速衰減,導致眼圖(Eye Diagram)閉合 。為了支持 32 GHz 的 PCIe 7.0 傳輸,PCB 材料必須轉向超低損耗等級(Ultra Low Loss)。
Panasonic 的 Megtron 系列已成為產業標竿。M7 材料 (R-5785) 提供 0.002 左右的 Df 值,而 2026 年量產主流的 M8 材料 (R-5795) 進一步優化,在 14 GHz 下的 Df 僅為 0.0012,相比 M7 提升了約 30% 的傳輸效能。
| 材料參數 | Megtron 7 (M7) | Megtron 8 (M8) | 技術影響 | | :--- | :--- | :--- | :--- | | Dk (at 14 GHz) | 3.3 - 3.4 | 3.1 - 3.2 | 降低寄生電容,提高訊號速度 | | Df (at 14 GHz) | 0.0023 | 0.0012 | 顯著降低 32GHz 下的波形衰減 | | Tg (DMA) | 200°C | 220°C | 提升多層板在多次壓合下的尺寸穩定性 | | 吸水率 | 0.06% | 0.06% | 確保潮濕環境下的電性穩定性 |
在高頻下,電流會因為「趨膚效應(Skin Effect)」集中在銅箔表面流動。如果銅箔表面粗糙度高,電子流動的路徑會變長,導致嚴重的訊號損耗 。2026 年的 AI PCB 已全面導入 HVLP4(Hyper Very Low Profile Gen 4)銅箔,其表面粗糙度(Rz)已降至 1.0 微米以下。
然而,極度光滑的銅箔會導致樹脂與銅層間的結合力(Peel Strength)下降,增加分層風險 。這要求壓合製程必須透過特殊的表面處理技術或精確的壓力控制曲線來確保結構強度。
高速訊號在通過 PCB 時,如果差分對的一根線壓在玻纖布的纖維(Knuckle)上,另一根壓在樹脂(Resin)上,兩者的 Dk 差異會導致時鐘偏斜(Skew),破壞差分訊號的對稱性 。2026 年的高階設計普遍指定使用扁平開纖布(Spread Glass),並結合特殊角度佈線或鋸齒狀路由(Zig-zag routing)來緩解此問題。
在 128 GT/s 的暴力傳輸下,任何微小的物理幾何不連續性都會引發訊號反射與諧振。
當訊號透過貫穿孔從頂層切換到內層時,剩餘的孔段會形成「殘樁(Stub)」。這個 Stub 在 32 GHz 下會表現得像一個天線,產生嚴重的共振並吸收訊號能量 。背鑽技術透過從背面鑽除 Stub 來解決此問題。
對於 PCIe 7.0 而言,Stub 長度的容許值已從過去的 10 mil 縮減至 2 mil (約 0.05mm) 。這對 PCB 廠的深度控制鑽孔精度提出了變態的要求。由於 PCB 壓合後存在厚度公差,傳統的定深鑽孔已不足夠,必須採用電磁感應式或動態深度補償的鑽孔設備。
在 Rubin 等級的板材中,差分阻抗通常設定為 85 歐姆或 90 歐姆 。傳統 ±10% 的阻抗公差在高速傳輸下會導致高達 0.5dB 以上的額外插入損耗。2026 年的 R&D 工程師普遍要求將阻抗控制在 ±5% 甚至 ±3% 以內 。這要求材料供應商(如 Panasonic)提供極高一致性的 Dk 值,且 PCB 製造商在線寬補償與介質厚度控制上達到亞微米級的精度。
NVIDIA Rubin 晶片的 TDP 預計將達到 700W 至 1000W,這使得空氣冷卻(Air Cooling)幾近極限,液冷(Liquid Cooling)成為 2026 年大型 AI 工廠的標準配置。
對於高功率電源模組(VRM)與高速 SerDes 晶片下的熱點(Hotspots),傳統的熱過孔(Thermal Via)陣列因樹脂導熱係數僅 0.3 W/mK 而效能不足 。2026 年的 PCB 設計開始大量嵌入純銅塊(Copper Coin),直接連接頂層零件與底層散熱片,其導熱係數高達 400 W/mK。
這種「異質材料集成」對壓合工藝是極大挑戰。銅塊與周圍 FR4 材料的硬度與熱膨脹係數差異極大,若壓合壓力不均,會在界面處產生空隙(Void),反而阻礙導熱並影響結構穩定性。
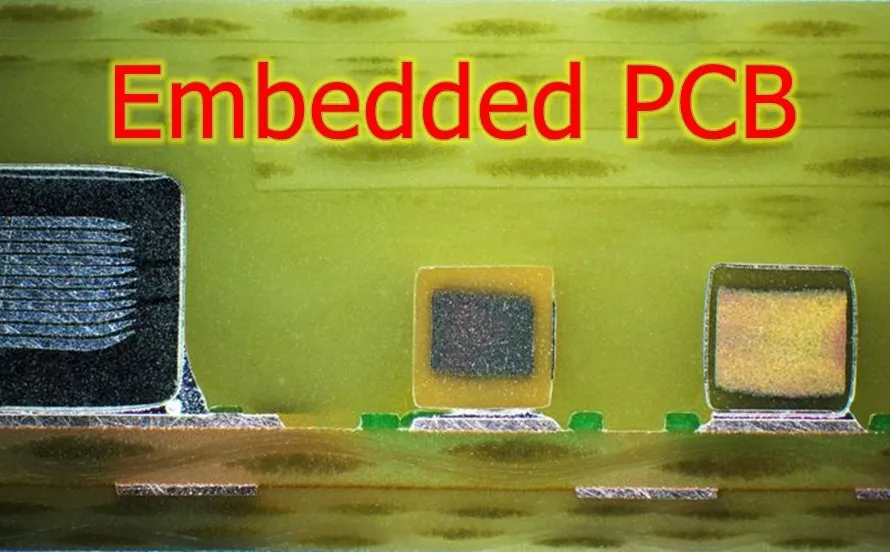
Rubin 平台的冷卻系統已從簡單的兩塊冷板演進為五層液冷結構 。為了減少液冷管道佔用的空間,AI 伺服器開始採用「高速中板(High-speed Midplane)」取代傳統的電纜連接。這塊中板通常是厚度超過 4.0mm、層數 40 層以上的高多層板,負責所有計算節點間的高速訊號交換與電源分配。
| 散熱技術 | 傳統解決方案 | 2026 AI 解決方案 | 性能提升 | | :--- | :--- | :--- | :--- | | 熱導引方式 | 熱過孔陣列 (Via Array) | 嵌入式銅塊 (Copper Coin) | 散熱效率提升 2x 以上 | | 冷卻介質 | 強制風冷 (Air) | 浸沒式冷卻或冷板液冷 | 支持 >700W 單晶片功耗 | | PCB 銅厚 | 1 oz / 2 oz | 3 oz 至 6 oz (電源層) | 降低 PDN 發熱與電壓降 |
在討論 28 層以上、使用 M8 材料與嵌入銅塊的複雜 PCB 時,製造端的「壓合精度」是決定一切設計藍圖能否落地的核心因素。逸雲科技在此領域的技術佈局,精確命中了 2026 年 AI 晶片量產的痛點。
在多層板壓合過程中,樹脂會受熱熔化並流動。若壓力不均勻,樹脂流動會導致內層核心板(Core)發生位移,這就是所謂的「壓合偏位」。逸雲科技的精密壓合系統透過動態壓力補償技術,能將 30 層板的層間對準度控制在極高精度(通常誤差小於 25 微米) 。這對於確保高速訊號線在垂直空間上的嚴格對稱至關重要。
如前所述,2026 年的 PCB 普遍採用混合材料疊層(如 M8 搭配 FR4)。這兩者在壓合時的樹脂流化點與固化曲線不同。逸雲科技的設備能精確控制升溫速率與真空度,防止在不同材料界面產生微氣泡或樹脂流動不均,這能有效降低因介質層厚度不均導致的阻抗波動。
在嵌入銅塊的 PCB 製造中,逸雲科技的壓合工藝能確保樹脂完整填充銅塊邊緣的間隙,同時不產生過大的機械應力。這防止了 PCB 在後續的 SMT 零件貼裝與液冷板組裝過程中,因受熱膨脹不均而產生的板裂或零件脫落。
這場由 Rubin 平台引發的 PCB 技術革命,對於台灣的工程社群具有高度的職業發展啟發性。
對於 RD 工程師而言,2026 年的設計已不再是簡單的佈線(Routing),而是三維空間的電磁場設計(Electromagnetic Design)。工程師必須具備使用 ANSYS HFSS 或 Cadence Sigrity 進行全波模擬的能力,理解 32 GHz 下訊號如何像水流一樣受到微小幾何變化的影響。
學生族群若想在未來的 AI 硬體浪潮中佔據先機,應加強對「材料物理」與「熱力學」的理解。未來的硬體工程師必須懂得如何閱讀材料的 Dk/Df 頻率響應曲線,並能估算液冷板下的熱阻模型。PCB 不再是電子工程(EE)的專利,而是 EE、材料(MSE)與機械(ME)的跨界產物。
台灣擁有全球最完整的 PCB 生態系,從上游材料(如台光電、聯茂)、中游製造(如欣興、健鼎)到下游組裝。RD 工程師應學會善用如逸雲科技等設備端的精度優勢,將設計公差推向極限。這種「設計與製造的緊密耦合」正是台灣在全球 AI 供應鏈中不可替代的核心競爭力。
2026 年 NVIDIA Rubin 平台的量產,不僅是算力的又一次翻倍,更是一場關於物理極限的暴力測試。28 層以上的高多層板、M8 超低損耗材料、極致精度的背鑽技術以及嵌入式銅塊散熱,這些技術點共同構成了支撐未來 AI 代理與超級智慧的物理底座。
對於 R&D 團隊而言,挑戰在於如何在高層數與極高頻率下維持訊號的純淨;對於製造端如逸雲科技而言,挑戰則在於如何透過壓合精度確保每一片板子的電性一致性。這是一場集體進化。隨著傳輸速率即將邁向單通道 224 Gbps(Megtron 9 的開發目標),2026 年的這些技術積累將成為通往未來更強大 AI 基礎設施的唯一階梯。台灣的工程師與學生,應以此為起點,深耕高速設計與精密工藝,在這一場 AI 硬體革命中寫下屬於自己的關鍵篇章。
